OPEROSTUDIO · JDE DATA TOOLING
JDE-Daten verstehen. Das Modell visuell aufbauen.
OperoStudio bringt das JD-Edwards-Schema in einen visuellen Arbeitsbereich. Tabellen und Felder finden, Beziehungen verstehen, Joins aufbauen und daraus wiederverwendbare Daten-Exporte erstellen — ohne sich durch F-Codes raten zu müssen.
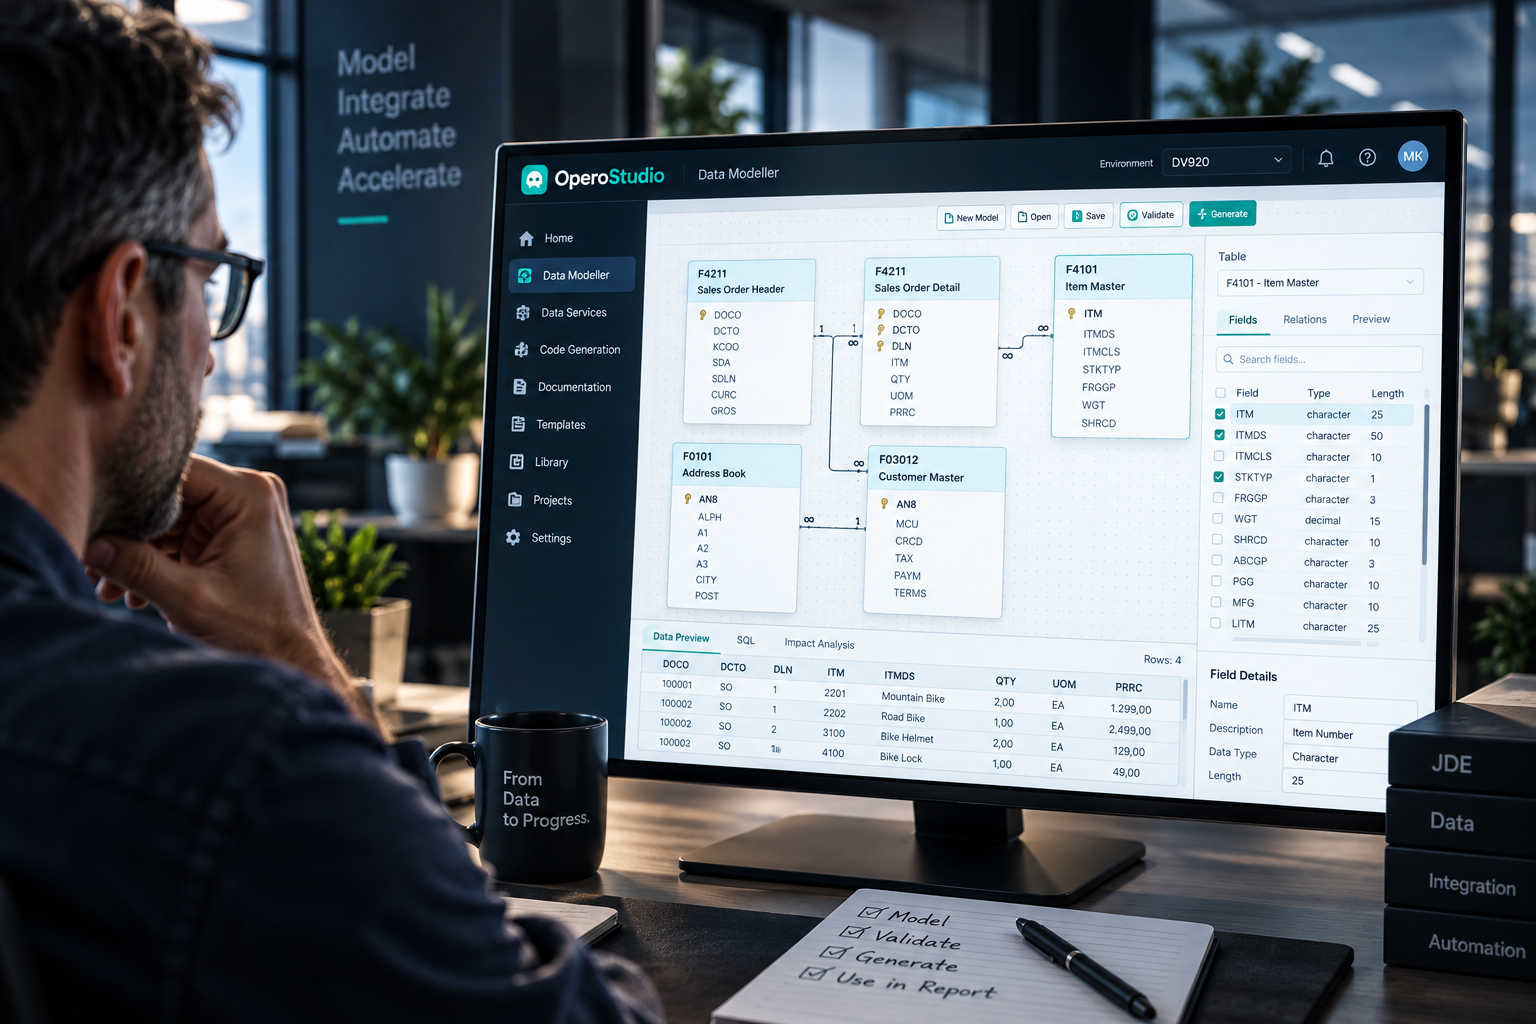
OPEROSTUDIO · DATA MODELLER
Tabellen, Beziehungen, Felder und Vorschau in einem Arbeitsbereich
WARUM OPEROSTUDIO
JDE-Daten werden verständlich, sobald man die Beziehungen sieht.
Wer mit JD-Edwards-Daten arbeitet, kennt das Problem: Die Informationen sind vorhanden, aber zu verstehen, welche Tabellen, Felder und Joins zusammengehören, braucht Erfahrung.
OperoStudio macht dieses Wissen zu einem visuellen Modell. Der Data Modeller erleichtert die Navigation im JDE-Schema. Extracts macht aus einem fertigen Modell nutzbare Daten für Reporting, Analyse und nachgelagerte Prozesse.
Von der F-Tabelle zum verständlichen Datenmodell — ohne den technischen JDE-Kontext zu verlieren.
Zwei Module
Zwei Bausteine für denselben JDE-Datenprozess.
Starten Sie mit dem Data Modeller, um JDE-Daten zu verstehen und zu modellieren. Nutzen Sie Extracts, wenn daraus ein wiederholbarer Datensatz für Reporting, Analyse oder Integration werden soll.Data Modeller
DM01_MODELLER
Visueller Schema-Browser und Datenmodell-Designer. Verstehen, was in JDE liegt, wie es verknüpft ist und was abgefragt werden kann.
- Komplettes JDE-Schema mit Klartext-Beschreibungen vorinstalliert
- Visueller Modell-Canvas mit Drag-and-Drop-Joins
- Fremdschlüssel-Erkennung mit automatischen Join-Vorschlägen
- Modelle als portable .osm-Dateien, versionierbar
Extracts
EX01_EXTRACTS
Macht aus einem Data-Modeller-Modell einen funktionierenden Datenexport. CSV, JSON, SQL — oder direkt ins Data Warehouse.
- Ein-Klick-Export als CSV, JSON, Excel oder Parquet
- Zeitgesteuerte Exporte für wiederkehrende Läufe
- SQL-Output für Warehouse-Ingestion (ELT)
- Filtern, transformieren, joinen zum Export-Zeitpunkt
Studio-Bundle: Beide Module zusammen — zu einem reduzierten Preis, mit einem einzigen Setup und einer einheitlichen Lizenz. Die meisten Kunden starten hier.
So funktioniert's
Vom JDE-Schema zum wiederverwendbaren Export.
OperoStudio läuft auf Ihrem Laptop. Es verbindet sich direkt zur JDE-Datenbank mit den Credentials Ihres DBAs. Nichts verlässt Ihre Umgebung.1
Installieren & verbinden
Desktop-App auf Windows, macOS oder Linux installieren. JDE-Datenbankverbindung anlegen — Read-only-Credentials genügen.2
Schema durchsuchen
Über den Tabellen-Browser finden, was Sie brauchen. Suche nach Thema, F-Code oder Feldname. Beschreibungen und Relationen sind vorinstalliert.3
Modell bauen
Tabellen auf den Canvas ziehen. OperoStudio schlägt Joins vor. Filter und Transformationen ergänzen. Vor dem Export validieren.4
Export
Ein Klick zu CSV, JSON oder Ihrem Data Warehouse. Zeitsteuerung für wiederkehrende Läufe. Modell speichern, beim nächsten Mal wiederverwenden.Anwendungsfälle
Wo ein visuelles JDE-Datenmodell am meisten hilft.
Typische Situationen, in denen Teams Tabellen, Beziehungen und Datenstrukturen verstehen müssen, bevor sie mit Reporting, Integration oder Analyse weiterkommen.
Report-Builder
Reports ohne Schema-Detektivarbeit.
Ihr Reporting-Team braucht Daten für ein neues Dashboard, weiß aber nicht, in welcher F-Tabelle sie liegen. Mit OperoStudio suchen sie „offene Rechnungen je Kunde", finden die richtigen Tabellen, bauen das Modell, exportieren die Daten — an einem Nachmittag, nicht in einer Woche.
Data Warehouse
Die JDE-zu-Warehouse-Pipeline.
Ihre Data Engineers müssen JDE ins Warehouse aufnehmen. OperoStudio liefert eine arbeitsfähige Karte der relevanten Tabellen, Beispiel-Exporte zur Validierung und wiederverwendbare Modelle, die zur Source-of-Truth für die ELT-Pipeline werden.
Integrations-Projekte
Wissen, was zu lesen ist, bevor man startet.
Ein neues System braucht JDE-Daten — welche Tabellen, welche Felder, welche Joins? OperoStudio beantwortet die Discovery-Fragen in Tagen, nicht Wochen. Die Integrations-Spezifikation schreibt sich fast von selbst, sobald das Modell klar ist.
Audit & Compliance
„Zeigen Sie mir, wo das im JDE passiert."
Wenn Auditoren fragen, wo spezifische Transaktionen liegen, gibt OperoStudio eine direkte Antwort — mit einem Modell, das die Datenspur belegt. Datensätze auf Anforderung exportieren. Lineage dokumentieren. Weiter.Welche JDE-Versionen werden unterstützt?
OperoStudio unterstützt JD Edwards EnterpriseOne 9.1 und 9.2 über alle Tools Releases. Die Schema-Metadaten werden mit dem Produkt ausgeliefert und aktualisiert, sobald Oracle neue ESUs herausbringt. Unterstützte Datenbanken: Oracle, SQL Server, IBM Db2, PostgreSQL.
Wie funktioniert die Preisgestaltung?
OperoStudio wird als einmalige Dauerlizenz verkauft — keine Subscription. Sie kaufen den Data Modeller, Extracts oder das Studio-Bundle — und besitzen es. Eine jährliche Wartung deckt Updates, Schema-Metadaten-Aktualisierungen und Support ab. Sprechen Sie uns an für eine Kalkulation.
Läuft es auf Mac und Linux?
Ja. OperoStudio ist eine Desktop-Anwendung für Windows 10/11, macOS 12+ und Linux (Ubuntu, RHEL, SUSE — aktuelle Versionen). Identischer Funktionsumfang auf allen Plattformen.
Was braucht die App, um auf JDE zuzugreifen?
Einen Read-only-Datenbank-User mit Select-Berechtigung auf dem JDE-Schema. Mehr nicht. OperoStudio verbindet sich nicht mit dem JDE-Web-Client und ändert nichts im JDE — es fragt die Datenbank direkt ab.
Für Db2 auf IBMi nutzt die Verbindung den IBM-JDBC-Treiber. Für Oracle/SQL Server/PostgreSQL sind Standard-JDBC-Treiber gebundled.
Wohin gehen die Daten? Wird etwas an Suppora übertragen?
Nichts. OperoStudio läuft vollständig auf Ihrem Laptop. Aus JDE abgefragte Daten bleiben auf Ihrer Maschine (oder in Ihrem lokalen Netzwerk, falls Sie auf ein Netzlaufwerk exportieren). Wir sehen Ihre Geschäftsdaten nie.
Das einzige, was mit unseren Servern spricht, ist die Lizenz-Aktivierung. Danach funktioniert die App offline.
Können Modelle im Team geteilt werden?
Ja. Modelle werden als portable
.osm-Dateien gespeichert — versionierbar, teilbar über Git, OneDrive oder jedes Dateisystem. Ein Kollege mit eigener Lizenz öffnet das Modell, lässt es gegen seine JDE-Verbindung laufen und bekommt dieselben Ergebnisse.
Was ist in der jährlichen Wartung enthalten?
Drei Dinge: neue Releases der App, Schema-Metadaten-Updates, sobald Oracle neue ESUs ausliefert (damit Ihre Tabellen-Beschreibungen aktuell bleiben), und Support — per E-Mail und Ticket, zu Geschäftszeiten, ~24h Antwortzeit. Wartung ist nach dem ersten Jahr optional, aber empfohlen.
Können wir OperoStudio vor dem Kauf testen?
Ja — wir stellen eine 30-Tage-Trial-Lizenz mit vollem Funktionsumfang bereit, ohne Zahlungsdaten. Nach Ablauf der Trial läuft die App im Read-only-Modus auf gespeicherten Modellen weiter — Sie verlieren Ihre Arbeit auch dann nicht, wenn Sie sich gegen einen Kauf entscheiden. Sprechen Sie uns an für eine Trial.